| پاسخ کوتاه
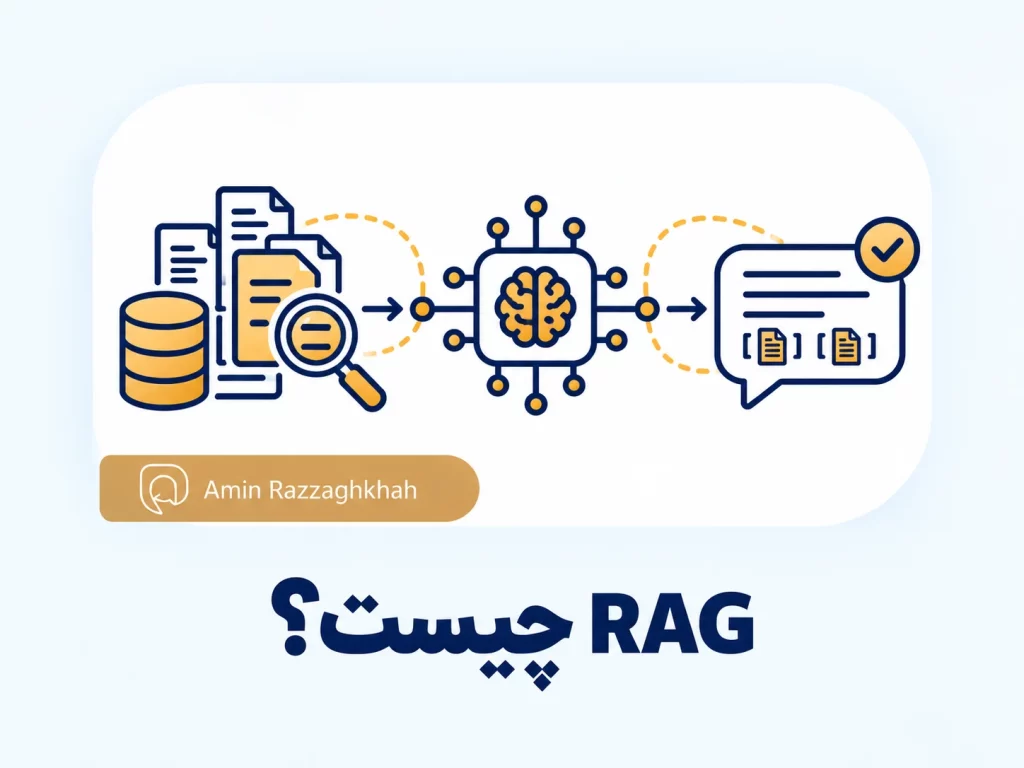
RAG (مخفف Retrieval-Augmented Generation، یعنی «تولید متن با تقویت بازیابی») روشی است که در آن مدل زبانی پیش از پاسخدادن، متنهای مرتبط را از یک منبع بیرونی پیدا میکند، آنها را کنار پرسش میگذارد و پاسخ را با تکیه بر همان متنها مینویسد. در پاسخگویی مبتنی بر RAG، اطلاعات بیرونی باید از مسیر بازیابی در اختیار مدل قرار بگیرند تا بتوانند در ساخت پاسخ استفاده شوند. بااینحال، بازیابی شدن به معنای استفاده شدن یا نمایش ارجاع نیست. گوگل در مستندات رسمیاش میگوید قابلیتهای هوش مصنوعی جستجو (AI Overviews و AI Mode) از RAG بهره میبرند [۱]. |
بحثهای GEO معمولاً از «چه بنویسیم» شروع میشوند. اما یک سؤال مقدمتر وجود دارد: وقتی یک سامانهی هوش مصنوعی به پرسش شما پاسخ میدهد، متن صفحهی ما اصلاً به دست مدل میرسد؟ RAG سازوکاری است که بخش بزرگی از پاسخ این سؤال را توضیح میدهد. نقد من در این مقاله هم مثل بقیهی سایت روی کیفیت اجراست، نه روی ارزش سئو: زنجیرهی SEO ← AEO ← GEO یک مسیر است و RAG یکی از ابزارهای فهم آن است.
اگر مبانی سئو را میخواهید، مقالهی سئو چیست؟ نقطهی شروع است؛ این مقاله مستقل خوانده میشود و حلقهای را نشان میدهد که سئوی سنتی را به پاسخهای تولیدشده با هوش مصنوعی وصل میکند.
| چطور شواهد این مقاله را بخوانید
هر ادعای مهم با برچسب منبعش آمده است: سطح ۱ یعنی مستندات رسمی موتور جستجو، سطح ۲ یعنی مقالهی داوریشده، پیشچاپ یعنی نسخهی آرکایو که داوری آن در منبع تأیید نشده، و تحلیل نویسنده یعنی برداشت خودم که شواهد مستقیم ندارد. شمارهها به فهرست منابع پایان مقاله اشاره میکنند. |
RAG دقیقاً چیست و با یک مدل زبانی ساده چه فرقی دارد؟
RAG ترکیب دو چیز است: یک مدل زبانی که متن تولید میکند و یک سازوکار بازیابی که از بیرونِ مدل، متن مرتبط میآورد. مقالهی Lewis و همکاران این دو را «حافظهی پارامتری» (دانشی که در وزنهای مدل ذخیره شده) و «حافظهی ناپارامتری» (منبع بیرونی) مینامد [۳]. RAG الزاماً جستجوی زندهی وب نیست: منبع بیرونی میتواند مجموعهای از اسناد از پیش آمادهشده باشد و تازگی پاسخ به تازگی همان منبع بستگی دارد.
یک تمثیل ملموس: مدل زبانی تنها مثل دانشجویی است که امتحان حفظی میدهد و هر چه در آموزش یاد گرفته را فقط از حافظه بیرون میکشد. RAG امتحان کتابباز است: دانشجو اول سراغ قفسه میرود، چند صفحهی مرتبط را پیدا میکند و بعد جواب را مینویسد. دانشجوی کتابباز هم میتواند اشتباه کند، مثلاً کتاب غلط را بردارد. این نکته بعداً مهم میشود.
|
ویژگی |
مدل بدون بازیابی و بدون منبع اضافی در ورودی | مدل زبانی با RAG |
| دانش از کجا میآید؟ | از پارامترهای مدل که در آموزش شکل گرفتهاند (و هر متنی که کاربر خودش در ورودی بگذارد) |
پارامترهای مدل بهاضافهی منبع بیرونی که در لحظهی پرسش خوانده میشود [۳] |
|
بهروزرسانی دانش |
در زمان انتشار مقالهی Lewis (۲۰۲۰) از مسائل باز پژوهشی بود [۳] | با تغییر منبع بیرونی ممکن میشود؛ مرور Gao آن را از مزایای RAG میشمارد [۴، پیشچاپ] |
| ردگیری منبع | در همان مقاله، ارائهی منبع تصمیمها از مسائل باز بود [۳] |
میتواند به صفحات بازیابیشده لینک بدهد، اما نمایش لینک ویژگی ذاتی RAG نیست و به طراحی محصول بستگی دارد؛ گوگل نمایش لینک را دربارهی قابلیتهای خودش توضیح میدهد [۱] |
|
ضعف اصلی |
توهم (hallucination) و دانش کهنه [۴، پیشچاپ] |
بازیابی اشتباه یا ناقص؛ مدل ممکن است منبع خوب را نیاورد یا بد بخواند [تحلیل نویسنده] |
RAG از کجا آمد و چه چیزی دربارهاش ثابت شده است؟
شواهد داوریشده (سطح ۲، ۲۰۲۰). Lewis و همکاران در NeurIPS 2020 یک روش آموزشِ عمومی برای ترکیب حافظهی پارامتری و ناپارامتری معرفی و ارزیابی کردند. مدلهایشان در سه آزمون پرسشوپاسخ دامنهباز به بهترین نتیجهی آن زمان رسیدند و در وظایف تولید متن، پاسخهایی مشخصتر، متنوعتر و واقعیتمحورتر از مدل صرفاً پارامتری تولید کردند [۳].
یک هشدار بازهی زمانی: این نتایج مربوط به مدلهای پژوهشی سال ۲۰۲۰ است. مقاله ارزش خودِ ایده را نشان میدهد، نه عملکرد محصولات امروزی مثل Gemini یا ChatGPT را.
مرور نظاممند (پیشچاپ، ۲۰۲۳–۲۰۲۴). مرور Gao و همکاران، که نسخهی پنجم آن در مارس ۲۰۲۴ منتشر شده، تکامل RAG را در سه الگو دستهبندی میکند: Naive، Advanced و Modular. همین مرور سه ستون RAG را بازیابی، تولید و تقویت (augmentation) مینامد و انگیزهی اصلی را سه مشکل مدلهای زبانی میداند: توهم، دانش کهنه و استدلال غیرشفاف و غیرقابلردگیری [۴]. در توصیف پایهی RAG هم آمده که سیستم، تکههای (chunks) مرتبط را از پایگاه دانش بیرونی با محاسبهی شباهت معنایی انتخاب میکند [۴]؛ همان مرور روشهای پیشرفتهتر را هم بررسی میکند (در ادامه).
به واژهی «chunk» دقت کنید: در این ادبیات، تکهها را خودِ سیستم از سندها میسازد. تکهتکهکردن متن وظیفهی سیستم است، نه نویسنده؛ در بخش «چه چیزهایی لازم نیست» به همین نکته برمیگردم.
یک پرسش از لحظهی پرسیدهشدن تا پاسخ نهایی چه مسیری را طی میکند؟
جدول زیر یک مسیر آموزشی ساده از پاسخگویی مبتنی بر بازیابی را نشان میدهد، نه معماری رسمی هیچ محصولی. در پیادهسازیهای واقعی بعضی مراحل تکرار میشوند: مرور Gao بازیابی تکرارشونده، بازگشتی و تطبیقی را توصیف میکند، که در آنها بازیابی میتواند در جریان تولید دوباره انجام شود یا حتی خودِ مدل تصمیم بگیرد کِی بازیابی کند [۴، بخش V]. نمایش ارجاع هم ویژگی ذاتی RAG نیست و به طراحی محصول بستگی دارد. جزئیات داخلی هر محصول عمومی نیست و من ادعایی دربارهی پیادهسازی دقیق گوگل یا شرکتهای دیگر نمیکنم.
|
مرحله |
چه اتفاقی میافتد؟ | برای صاحب سایت یعنی چه؟ |
| ۱. فهم پرسش | پرسش تحلیل میشود. در AI Overviews و AI Mode ممکن است چند پرسش مرتبط همزمان ساخته شود (query fan-out) [۱، ۲] |
صفحه باید به زیرپرسشها هم جواب بدهد، نه فقط به عبارت اصلی |
|
۲. بازیابی |
صفحات یا تکههای مرتبط از منبع پیدا میشوند؛ در گوگل این منبع نمایهی جستجوست [۱، ۴] | اگر صفحه به نمایه یا ابزار بازیابی نرسد، فرصت ورود به این مسیر را کمتر دارد؛ وضعیت دقیق به نمایهی موجود و ابزار بستگی دارد [تحلیل نویسنده] |
| ۳. تقویت | متنهای بازیابیشده کنار پرسش در اختیار مدل قرار میگیرند [۴] |
فقط بخشهای انتخابشده دیده میشوند؛ بخشهای مبهم شانس کمتری دارند [تحلیل نویسنده] |
|
۴. تولید |
مدل پاسخ را با تکیه بر همان متنها مینویسد [۱، ۳] | جملههای روشن و دقیق سادهتر به پاسخ تبدیل میشوند [تحلیل نویسنده] |
| ۵. نمایش منابع (در سامانههایی که این قابلیت را دارند) | در گوگل لینک صفحات پشتیبان کنار پاسخ نمایش داده میشود [۱] |
اگر لینک نمایش داده شود، «دیده شدن» همینجا اتفاق میافتد؛ بازیابی یا استفاده از متن لزوماً به نمایش لینک نمیرسد |
مرحلهی بازیابی میتواند بر تطبیق واژگانی، بازنمایی معنایی یا ترکیبی از آنها تکیه کند؛ مرور Gao روشهای تنک (مثل BM25)، متراکم و ترکیبی را بررسی میکند [۴، بخش III]. پس از آن ممکن است نتایج بازرتبهبندی شوند و بخشهای مناسب برای ورودی مدل انتخاب یا فشرده شوند [۴، بخش IV]. این توضیح معماری دقیق هیچ محصول تجاری مشخصی را اثبات نمیکند. بازنماییهای عددی (embedding) که در مقالهی هوش مصنوعی محتوا را چطور میخواند و میفهمد؟ توضیح دادم یکی از ابزارهای رایج مرحلهی بازیابیاند.
برای فارسی یک لایهی دیگر هم هست. در آزمایش توکنشماری مقالهی ماشین فارسی را چطور میخواند؟ دیدیم که یک متن فارسی بسته به انکودینگ، تعداد توکن بسیار متفاوتی تولید میکند. این بهتنهایی ثابت نمیکند بازیابی فارسی ضعیفتر است؛ آن ادعا اندازهگیری جداگانه میخواهد.
آیا گوگل واقعاً از RAG استفاده میکند؟
بله، و خودش هم این را رسماً گفته است. سطح ۱ — راهنمای رسمی گوگل برای قابلیتهای هوش مصنوعی مولد (آخرین بهروزرسانی ۱۰ ژوئیه ۲۰۲۶). گوگل RAG را (با نام دیگر grounding) تکنیکی توصیف میکند که کیفیت، دقت و تازگی پاسخهای هوش مصنوعی را با تکیه بر سیستمهای رتبهبندی اصلی جستجو بالا میبرد: صفحات مرتبط و بهروز از نمایهی جستجو بازیابی میشوند، سیستم اطلاعات آنها را میخواند، پاسخ میسازد و لینک صفحات پشتیبان را نشان میدهد [۱].
همان مستند query fan-out را هم توضیح میدهد: مدل چند پرسش همزمان و مرتبط تولید میکند تا نتایج بیشتری بیاورد. مثال خودِ گوگل پرسشی دربارهی درمان چمنِ پر از علف هرز است که به زیرپرسشهایی مثل بهترین علفکشها، حذف علف هرز بدون مواد شیمیایی و پیشگیری از رویش دوباره تقسیم میشود [۱].
سه نکتهی دیگر از همین مستندات و راهنماهای وابسته (سطح ۱):
- شرط واجدشرایطبودن: صفحه باید ایندکس شده و برای نمایش همراه با snippet در جستجو واجد شرایط باشد. مستند ۲۰۲۵ میگوید شرط فنی اضافهای برای خودِ محتوا وجود ندارد، و تضمینی هم برای کراول، ایندکس یا نمایش نیست [۲، آخرین بهروزرسانی ۱۰ دسامبر ۲۰۲۵].
- تنظیم اجازهی حضور: مستند جدیدتر [۱] علاوه بر ایندکس و snippet، به «شامل بودن» سایت در تنظیم Search generative AI در Search Console اشاره میکند. طبق راهنمای اختصاصی آن، حالت پیشفرض شامل بودن است، مالک property میتواند آن را تغییر دهد، تنظیم روی AI Overviews، AI Mode و قابلیتهای مولد Discover اثر دارد، و آموزش مدلها جداگانه با Google-Extended کنترل میشود [۷]. پس بین «نبود شرط فنی اضافه برای محتوا» و «اجازهی حضور» تفاوت هست؛ دو مستند هم در زمان بهروزرسانی فرق دارند.
- تفاوت AI Overviews و AI Mode: هر دو ممکن است از مدلها و تکنیکهای متفاوتی استفاده کنند، پس مجموعهی پاسخها و لینکها یکسان نیست. AI Overviews هم فقط وقتی نمایش داده میشود که سیستم آن را مفید تشخیص دهد و اغلب اصلاً فعال نمیشود [۲].
گوگل دربارهی برچسبهای AEO و GEO هم موضع روشنی دارد: از دید جستجوی گوگل، بهینهسازی برای تجربهی جستجوی مولد همچنان همان سئوست [۱]. این با چارچوب این سایت (زنجیرهی واحد SEO ← AEO ← GEO) همخوان است، با یک تفاوت مهم: اینکه سئو را «سئو» بنامیم یا «GEO»، بحث بر سر برچسب است؛ بحثِ جدی بر سر کیفیت اجرا است.
RAG چه ربطی به GEO و AEO دارد؟
SEO، AEO و GEO حوزههایی همپوشاناند که بر دسترسپذیری، پاسخگویی و حضور در پاسخهای مولد تمرکز میکنند؛ نمیتوان هرکدام را به یک مرحلهی انحصاری RAG محدود کرد و رقیب هم نیستند. جدول زیر فقط نشان میدهد هرکدام بیشتر به کدام بخش مسیر دیده شدن نزدیک است. این نگاشت تحلیل خودم است و تقسیمبندی رسمی هیچ موتور جستجویی نیست.
|
لایه |
سؤال کلیدی | ارتباط با مسیر دیده شدن |
| SEO | آیا صفحه کراول، ایندکس و بازیابی میشود؟ |
بیشتر به دسترسپذیری و بازیابیشدن مربوط است |
|
AEO |
آیا صفحه پاسخ مستقیم و قابلاستخراج به سؤال دارد؟ | بیشتر به پاسخگویی روشن و قابلاستخراج مربوط است |
| GEO | آیا در پاسخ نهایی انتخاب و ارجاع داده میشود؟ |
بیشتر به حضور و انتخاب در پاسخ نهایی مربوط است |
در پاسخهای مبتنی بر RAG، بازیابی شرط لازم است اما کافی نیست: صفحهای که بازیابی نشود، متنش در آن پاسخ استفاده نمیشود، و صفحهی بازیابیشده هم لزوماً استفاده یا ارجاع داده نمیشود [تحلیل نویسنده].
دربارهی بهینهسازی مستقیم برای پاسخهای مولد، مقالهی Aggarwal و همکاران (KDD 2024، سطح ۲) چارچوب GEO را معرفی کرد و با یک بنچمارک جدید نشان داد دیده شدن در پاسخ موتورهای مولد تا ۴۰ درصد قابل افزایش است. همان چکیده میگوید اثربخشی روشها از حوزهای به حوزهی دیگر فرق میکند [۵]. دو احتیاط لازم است: عدد ۴۰ درصد سقف است نه میانگین، و به محیط آزمایشی همان مقاله مربوط است. تعمیم خودکارش به AI Overviews گوگل ادعای جداگانهای است که این مقاله ثابت نکرده است.
برای مرور انتقادی اینکه دربارهی GEO چه چیزی واقعاً ثابت شده، مقالهی GEO چیست؟ را ببینید.
برای دیده شدن در پاسخهای هوش مصنوعی عملاً چه باید کرد؟
ترتیب کارها: اول دسترسی و بازیابیپذیری، بعد قابلاستنادبودن.
- اجازهی کراول را در همهی لایهها بررسی کنید. گوگل صراحتاً میگوید کراول باید هم در robots.txt و هم توسط هر CDN یا زیرساخت هاستینگ مجاز باشد (سطح ۱) [۲].
- تنظیم Search generative AI را در Search Console بررسی کنید. حالت پیشفرض «شامل» است؛ اگر سایت یا یک property زیرمجموعهاش را کنار گذاشتهاند، لینک و محتوای آن در AI Overviews، AI Mode و قابلیتهای مولد Discover نمایش داده نمیشود. تغییر معمولاً ظرف یک تا دو روز اعمال میشود (سطح ۱) [۷].
- شرط ایندکس و snippet را حفظ کنید. صفحهای که با کنترلهایی مثل nosnippet یا max-snippet محدود شده، دقیقاً همان چیزی را محدود کرده که برای نمایش در این قابلیتها لازم است (سطح ۱) [۲].
- محتوای غیرکالایی (non-commodity) بنویسید. گوگل میگوید دیدگاه یکتا و تجربهی دستاول احتمالاً در بلندمدت بیشتر از هر توصیهی دیگر روی حضور در جستجوی مولد اثر میگذارد. بازنویسی چیزی که همه گفتهاند، یا چیزی که یک مدل زبانی هم بهراحتی تولید میکند، ارزشی ندارد (سطح ۱) [۱].
- ساختار را برای خواننده بچینید. پاراگراف، بخش و تیتر روشن، چیزی است که گوگل خودش پیشنهاد میکند (سطح ۱) [۱]. در این سایت تیترها را تا جای ممکن به شکل سؤال واقعی کاربر مینویسم؛ این رویهی سایت است، نه توصیهی رسمی گوگل.
- جواب را اول هر بخش بگذارید. دلیل اصلی ساده است: خوانندهی انسانی میخواهد سریع به پاسخ برسد [تحلیل نویسنده]. پژوهش Liu و همکاران (TACL 2024، سطح ۲) را فقط شاهدی کنار آن میگذارم: در آزمایشهای آن مقاله، عملکرد مدلها وقتی اطلاعات مرتبط در ابتدا یا انتهای ورودی بود معمولاً بهتر بود و وقتی وسط ورودی بلند قرار میگرفت بهطور چشمگیری افت میکرد [۶]. این یافته دربارهی ورودی مدل در همان آزمایشهاست، نه دربارهی صفحات وب؛ ابتدای یک بخش از صفحه هم لزوماً ابتدای ورودی نهایی مدل نیست، و پژوهش دربارهی همهی مدلهای امروزی حکم نمیدهد.
- ادعاهای قابلبررسی بنویسید. هر ادعا را با منبع، سطح شواهد و بازهی زمانی بیاورید. این رویهی خود این سایت است و کار را برای خواننده و برای هر سیستمی که بخواهد درستی متن را بسنجد ساده میکند [تحلیل نویسنده]. این رویه برای شفافیت و امکان بررسی ادعاهاست؛ اثر مستقل آن بر احتمال حضور یا ارجاع گرفتن در پاسخهای مولد در منابع این مقاله اندازهگیری نشده است.
- اندازه بگیرید، حدس نزنید. طبق راهنمای اختصاصی گوگل (سطح ۱)، «گزارش عملکرد هوش مصنوعی مولد» از ۳۱ اوت ۲۰۲۶ برای همهی سایتها عرضه شده، نمایش (impression) لینکهای سایت را در AI Overviews و AI Mode میسنجد، مکمل گزارش Performance است و دادهی نوع جستجوی Web را هم شامل میشود [۸]. مستند ۲۰۲۵ هم میگوید ترافیک این قابلیتها در گزارش Performance شمرده میشود [۲]. این گزارش نمایش لینک را میسنجد؛ مواردی را که متن بازیابی شده یا بدون ارجاع استفاده شده نشان نمیدهد [تحلیل نویسنده]. هیچ ابزار شخص ثالثی هم به سیستمهای رتبهبندی داخلی گوگل دسترسی ندارد [۱].
| تجربهی خودم روی همین سایت
در یک آزمون دسترسی با ابزار مبتنی بر Claude روی amin.ceo، دریافت صفحه با مانع مواجه شد، در حالی که robots.txt سایت باز بود. این مشاهده بهتنهایی علت مسدودسازی یا رفتار همهی رباتهای آن سرویس را مشخص نمیکند؛ فرضیهی فعلی من لایهی Cloudflare/CDN است، نه نتیجهی اثباتشده [تحلیل نویسنده]. تفاوت را اینطور میفهمم: robots.txt مثل تابلوی «ورود آزاد» جلوی در است و فایروال مثل نگهبانی که کارت میخواهد. دقت کنید این مورد دربارهی کراولر یک ابزار هوش مصنوعی بود، نه Googlebot. برای گوگل باید جداگانه با ابزار URL Inspection بررسی کرد که صفحه به همان شکلی که باید دیده میشود [۲]. |
چه کارهایی را برای RAG و پاسخهای هوش مصنوعی گوگل لازم نیست انجام بدهید؟
مستند رسمی گوگل (سطح ۱، بهروزرسانی ۱۰ ژوئیه ۲۰۲۶) فهرستی از «میانبرهای» رایج را کنار میگذارد [۱]:
- فایل llms.txt و فایلهای ماشینخوان ویژه: جستجوی گوگل از آنها استفاده نمیکند. ساختنشان برای سیستمهای دیگر اشکالی ندارد، اما برای گوگل نه کمک میکند نه ضرر میزند.
- تکهتکهکردن محتوا (chunking) برای هوش مصنوعی: الزامی برای شکستن متن به قطعههای ریز نیست. تقسیمبندی که در ادبیات RAG دیدیم کار خودِ سیستم است.
- بازنویسی محتوا فقط برای ماشین: لازم نیست به شکل خاصی برای هوش مصنوعی بنویسید؛ سیستمها مترادفها و معنای کلی را میفهمند.
- دنبال «ذکر» مصنوعی نام برند در سایتهای دیگر بودن: به گفتهی گوگل این کار به اندازهای که به نظر میرسد مفید نیست.
- وسواس دربارهی structured data: برای قابلیتهای مولد الزامی نیست و schema.org ویژهای هم لازم ندارد. استفادهی عادی از آن برای نتایج غنی همچنان خوب است.
- ساختن صفحهی جدا برای هر پرسش فناوت (fan-out): اگر هدفش دستکاری رتبه یا پاسخهای مولد باشد، گوگل آن را مشمول سیاست «محتوای انبوه» (scaled content abuse) میداند.
یک محدودیت صادقانه: این فهرست فقط برای جستجوی گوگل سطح ۱ است. ChatGPT، Perplexity و سیستمهای دیگر مستندات و رفتار خودشان را دارند و من برای آنها شواهد رسمی همسطح ندارم، پس دربارهشان حکم قطعی نمیدهم.
محدودیتهای RAG چیست و چرا «ارجاع داده شدن» تضمین نیست؟
- بازیابی میتواند خطا کند. مرور Gao فهرستی از چالشهای باز RAG ارائه میکند و آن را «راهحلی امیدبخش» مینامد، نه راهحلی قطعی [۴، پیشچاپ].
- جایگاه اطلاعات در ورودی مهم است. اگر متن درست بازیابی شود اما در میانهی ورودی بلندی قرار بگیرد، مدل ممکن است کمتر از آن استفاده کند [۶].
- نمایش تضمینشده نیست. گوگل میگوید حتی صفحهای که همهی شرطها را دارد، لزوماً کراول، ایندکس یا نمایش داده نمیشود [۱، ۲].
- هر سیستم رفتار خودش را دارد. AI Overviews و AI Mode میتوانند مدل و تکنیک متفاوتی داشته باشند [۲].
نتیجهی عملی: دیده شدن در پاسخهای هوش مصنوعی را احتمالی بدانید. کار شما بالا بردن احتمال در هر مرحله است، نه خرید ضمانت.
پرسشهای متداول
RAG با فاینتیونینگ فرق دارد؟
بله. فاینتیونینگ پارامترهای خودِ مدل را با آموزش بیشتر تغییر میدهد. RAG در لحظهی پاسخ، متن بیرونی هم به مدل میدهد (همان حافظهی ناپارامتری [۳]). این دو رقیب هم نیستند: روش Lewis و همکاران خودش یک دستور آموزشی (fine-tuning) برای ساختن مدلهای RAG است [۳].
از کجا بفهمم صفحهام بازیابی میشود؟
ابزار عمومیای که بازیابی داخلی را نشان بدهد وجود ندارد. گوگل هشدار میدهد هیچ ابزار شخص ثالثی به سیستمهای رتبهبندی داخلیاش دسترسی ندارد [۱]. نزدیکترین راه برای گوگل، گزارش عملکرد هوش مصنوعی مولد در Search Console است که نمایش لینکها را نشان میدهد [۸]، بهاضافهی آزمون دستی پرسشهای هدفتان؛ اینها بازیابی داخلی را نشان نمیدهند.
باید llms.txt بسازم؟
برای جستجوی گوگل نه [۱]. اگر سیستم دیگری آن را میخواند، ساختنش آزاد است ولی من شواهدی از اثر آن ندارم.
RAG جای سئو را میگیرد؟
طبق مستندات گوگل نه: قابلیتهای هوش مصنوعی جستجو بر سیستمهای رتبهبندی و کیفیت اصلی سوارند [۱]. RAG لایهی تازهای روی بازیابی است، نه جایگزین آن.
گام بعدی: سایت شما برای مرحلهی بازیابی آماده است؟
اگر میخواهید وضعیت سایتتان را از دید الگوریتم بررسی کنم (دسترسی کراولرها از جمله لایهی CDN، واجد شرایط بودن ایندکس و snippet، و ساختار پاسخهای صفحات اصلی)، از طریق صفحهی تماس amin.ceo پیام بدهید. اگر پرسشی دربارهی این مقاله دارید، آن را همانجا بنویسید تا در بازبینی بعدی پاسخ بدهم.
RAG ابزار امروز است. اگر به این فکر میکنید که چنین مسیرهایی در افق مفاهیمی مثل AGI و ASI چه سرنوشتی پیدا میکنند، مقالهی AGI و ASI چیست؟نگاه بلندمدتتر را میدهد.
| جمعبندی
۱. RAG یعنی مدل پیش از پاسخ، متن مرتبط را از منبع بیرونی میآورد؛ گوگل رسماً میگوید AI Overviews و AI Mode از آن بهره میبرند [۱]. ۲. در پاسخهای مبتنی بر RAG، بازیابی شرط لازم است اما کافی نیست؛ بازیابی شدن به معنای استفاده شدن یا ارجاع گرفتن نیست [تحلیل نویسنده]. ۳. کارهای اصلی همان بنیادهای سئو هستند: دسترسی کراول در همهی لایهها، ایندکس، تنظیم Search generative AI و محتوای یکتا و قابلاستناد؛ میانبرهایی مثل llms.txt برای گوگل اثری ندارند [۱]. |
منابع
لینکها و تاریخهای بهروزرسانی در ۲ آبان ۱۴۰۵ (۲۴ اکتبر ۲۰۲۶) بررسی شدهاند. ادعاها با چکیده یا متن بازیابیشدهی هر منبع تطبیق داده شدهاند.
[۱] سطح ۱ (مستندات رسمی) · آخرین بهروزرسانی ۱۰ ژوئیه ۲۰۲۶
Google Search Central. “Optimizing your website for generative AI features on Google Search.”
https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
[۲] سطح ۱ (مستندات رسمی) · آخرین بهروزرسانی ۱۰ دسامبر ۲۰۲۵
Google Search Central. “AI features and your website.”
https://developers.google.com/search/docs/appearance/ai-features
[۳] سطح ۲ (مقالهی داوریشده) · NeurIPS 2020
Lewis, P., Perez, E., Piktus, A., et al. (2020). “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” arXiv:2005.11401.
https://arxiv.org/abs/2005.11401
https://papers.nips.cc/paper/2020/hash/6b493230205f780e1bc26945df7481e5-Abstract.html
[۴] پیشچاپ آرکایو (داورینشده) · نسخهی ۵، مارس ۲۰۲۴ · بخشهای III، IV و V مورد استناد
Gao, Y., Xiong, Y., Gao, X., et al. (2023). “Retrieval-Augmented Generation for Large Language Models: A Survey.” arXiv:2312.10997v5.
https://arxiv.org/abs/2312.10997v5
[۵] سطح ۲ (مقالهی داوریشده) · پذیرفتهشده در KDD 2024 · لینک نسخهی رسمی کنفرانس بررسی نشد
Aggarwal, P., Murahari, V., Rajpurohit, T., et al. (2024). “GEO: Generative Engine Optimization.” arXiv:2311.09735v3.
https://arxiv.org/abs/2311.09735v3
[۶] سطح ۲ (مقالهی داوریشده) · TACL 2024
Liu, N. F., Lin, K., Hewitt, J., et al. (2024). “Lost in the Middle: How Language Models Use Long Contexts.” Transactions of the ACL, 12, pp. 157–173. DOI: 10.1162/tacl_a_00638.
https://aclanthology.org/2024.tacl-1.9/
[۷] سطح ۱ (راهنمای رسمی Search Console) · عرضهی سراسری ۳۱ اوت ۲۰۲۶
Google Search Console Help. “Search generative AI control.”
https://support.google.com/webmasters/answer/16908024
[۸] سطح ۱ (راهنمای رسمی Search Console) · عرضهی سراسری ۳۱ اوت ۲۰۲۶
Google Search Console Help. “Generative AI performance report (Search).”